60/100
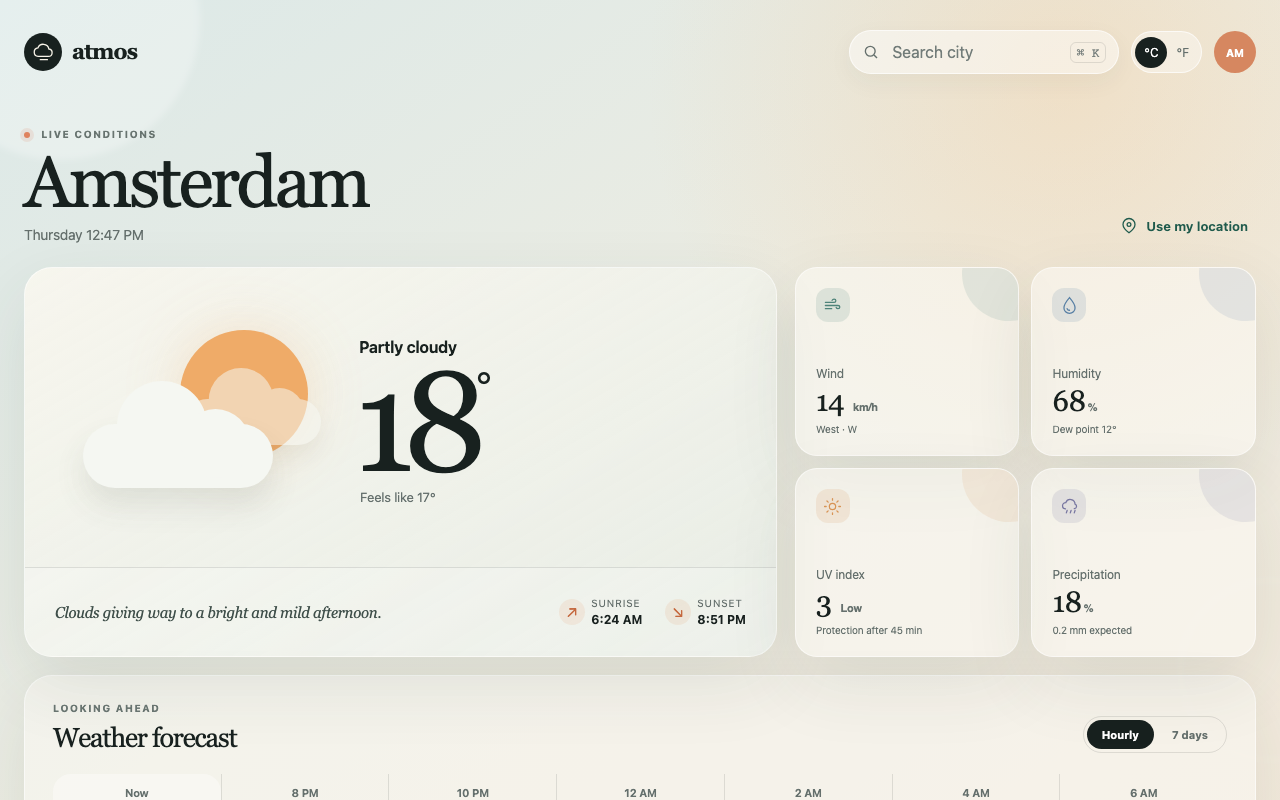
视觉外壳精致完整,但数据 100% 硬编码却以"● LIVE CONDITIONS"呈现、真实披露只在页脚小字,题目要求的"运行→浏览器打开→自行检查→修复→重复"没有任何可核验证据。
- 数据来源(本题最重要的事实):
app.js顶部的cities常量(Amsterdam / Copenhagen / Lisbon / Tokyo / Vancouver)是唯一数据源;artifacts/内检索fetch/XMLHttpRequest/http(s):///async/await/Promise全部 0 命中。因此不存在真实的加载、失败、超时、缓存或"缺失字段"路径——凡是按"实时接口"设计的验收项,实际上都没有可失败的对象。
- 需求对照:呈现地点/当前天气/温度/体感/关键指标/逐小时与 7 天预报 ✅(视觉桥接模型确认这些区块齐备);加载、失败、空数据、刷新四态 ✗(无任何状态节点,
render()同步执行);数据真实性 ✗;按题目要求"自行检查渲染结果并修复" ✗(见下)。
- 误导性呈现(扣分主因):页面以带常亮点的 "● LIVE CONDITIONS" 标题呈现硬编码数据,而真实性披露只在页脚小字 "Updated just now · Local demo data",同一屏内自相矛盾。相关细节互相打架,可复现:
0.2 mm expected与Protection after 45 min是写死的阿姆斯特丹数值,切到别的城市或切 °F 后变成错误信息;- 预报图标完全不读
condition字段(只按索引与降水阈值选太阳/云),出现"当前 Clear skies 却显示云"的互斥; - 时区换算把
new Date().getTimezoneOffset()加了正号(符号相反);小时刻度用浏览器本地小时递推,忽略城市的offset; - 7 天标签从
i+2取星期名,跳过一天且不校验星期几; - 搜索只匹配 5 个硬编码城市(输入 Paris 得到 "No saved cities found");"Use my location" 只弹提示,未调用
navigator.geolocation; - 切到 °F 后大号温度旁仍只有
°,无 C/F 指示;无主题切换控件,也没有prefers-color-scheme。
- 过程证据缺失(题目逐条要求的自检闭环):原题明确写"1. 运行应用;2. 在浏览器中打开;3. 自行检查渲染结果;4. 修复发现的视觉或功能问题;5. 重复直到满意"。归档中该 run 的工具构成为
exec_command=6, apply_patch=2,没有任何浏览器渲染、截图或view_image调用,artifacts/也只有 3 个源文件、无任何截图产物。需要说明的是:该 run 的recordedCommands在审计 JSON 中为空数组,无法排除模型用exec_command直接打开过浏览器,但没有任何记录或产物支持它完成了这一循环,因此本评价按"未提供证据"处理,而非按"已执行"处理。
- 成立且值得肯定的部分:零依赖、
file://直接可用;单位换算集中在两处函数、温度/体感/露点/高低温/风速联动一致;三档响应式(窄屏预报改为横向scroll-snap);prefers-reduced-motion、:focus-visible、aria-expanded/controls、role="tablist"、aria-livetoast 等无障碍基础扎实;视觉维度盲看给 9/10(版式干净、层级清晰、无溢出重叠)。
- 扣分:需求符合度 −20(自检闭环无证据 −10、数据真实性与披露 −10);完整度 −5(四态全缺);正确性 −11(时区/单位/图标/日期/搜索/定位等互斥项);视觉 −1;工程 −3。
- 跨题意义:本题是"看起来完成了"与"真的完成了"落差最大的样本——唯一能识别它的方式是读数据来源,而不是看界面。
- 局限:本评价未做真实网络环境复核(该 run 本身网络关闭);对比度是否达标未测量;视觉结论来自视觉桥接模型;
recordedCommands为空使我们无法枚举该 run 的 6 次 shell 命令。
评分口径: 需求符合度 40 / 功能完整度 20 / 正确性 20 / 视觉与产品感 10 / 工程组织 10;自定口径,不可与其他模型或阶段比较 引用结论,不代表网站独立复验维护 agent v3(AI,非盲评) ↗